自适应学习系统:知识点掌握度模型与推荐逻辑的边界
教育科技产品常以「自适应」作为卖点,宣称能根据学生水平动态调整内容。这个能力背后是一套知识点建模与概率估计的技术栈,效果好坏取决于三个前提:知识点拆得够细、题目标定得够准、数据积累得够多。任何一环缺失,自适应就退化为按规则跳转。
一、自适应与「按顺序播放」的区别
按顺序播放的系统只判断对错,答错就重复本节,答对就进入下一节。自适应系统会维护每个知识点的掌握概率,答错时判断是前置知识缺失还是当前知识点未掌握,并据此选择补救路径。差别在于是否建立了知识点之间的依赖关系。没有依赖图的系统,本质上仍是线性课程加分支跳转。
二、知识图谱的构建前提
知识图谱把学科内容拆成可测量的最小单元,并标注前置依赖。以初中数学为例,一元二次方程的求解依赖因式分解与配方法,而配方法又依赖完全平方公式。拆解粒度决定诊断精度,粗到「函数」这一级就无法定位具体缺口。构建图谱需要学科专家与教研团队逐条梳理,工作量集中在前期,且需要随教材调整持续维护。
三、掌握度估计的常用模型
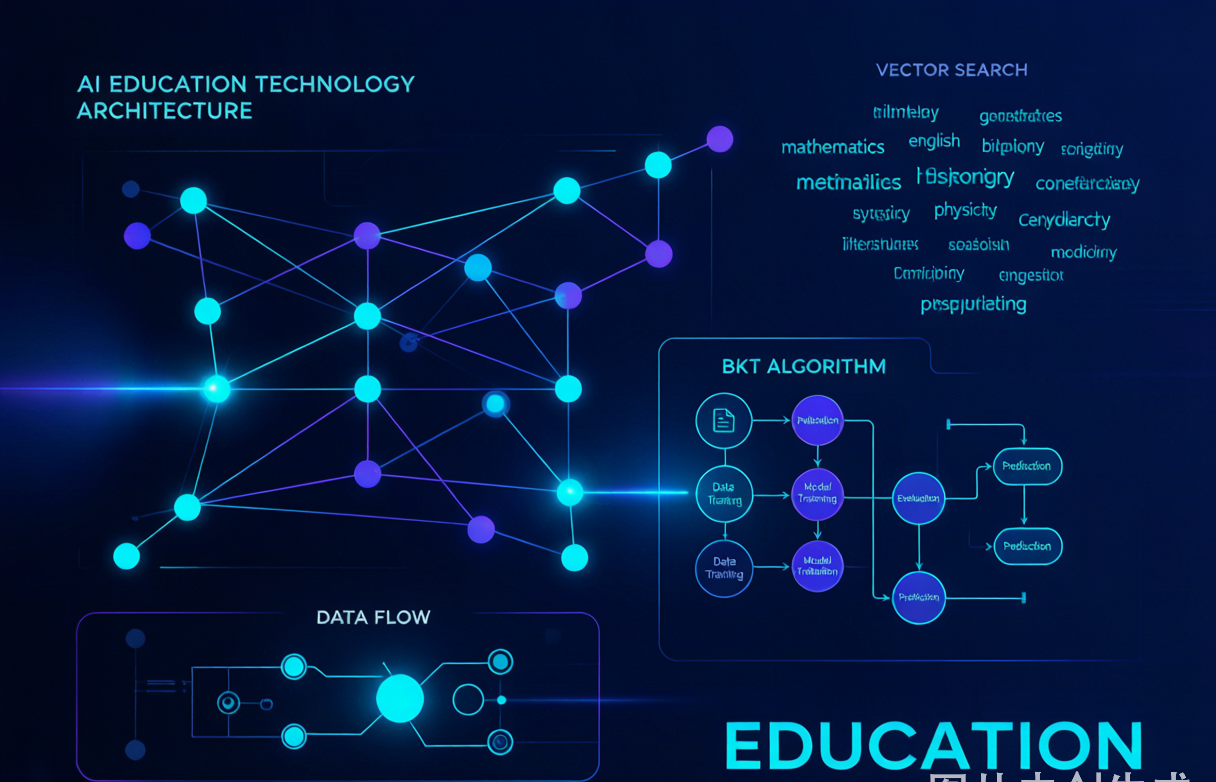
主流方法是贝叶斯知识追踪及其改进版本,用四个参数描述学生的答题表现:已掌握时的答对率、未掌握时的答对率、从未掌握到掌握的转移概率、从掌握到遗忘的转移概率。深度知识追踪模型用循环神经网络替代参数估计,在数据量充足时精度更高。两类模型都需要足够多的答题记录才能稳定收敛。
四、题目难度标定的难点
自适应推荐依赖每道题的难度参数,难度需通过大量作答数据统计得出,而非教师主观判断。新题在没有作答数据时无法标定难度,只能冷启动。不同群体的难度感知也不同,同一道题在重点校与普通校的正确率差异可能达到三十个百分点。用单一难度值描述题目,在多群体场景下会产生系统性偏差。
五、推荐逻辑的三种策略
第一种是掌握度优先,选择掌握概率接近百分之七十的知识点,落在最近发展区内。第二种是考试权重优先,按考纲分值分布调整推荐顺序。第三种是遗忘曲线优先,对已掌握但临近遗忘的知识点安排复习。三种策略的目标不同,实际系统通常按权重混合,混合比例决定了产品偏向补差还是提分。
六、冷启动与数据稀疏
新用户没有历史数据,系统只能用入学测评做初始估计,精度有限。小众学科、冷门地区的作答样本少,模型参数估计不稳定。解决方式包括借用相似群体的先验分布、增加诊断性测评的题量、引入教师的人工判断。冷启动阶段的推荐质量通常明显低于成熟阶段,这一点在产品宣传中很少被提及。
七、可解释性的缺失
学生答错一道题,系统判定为「知识点未掌握」,但真实原因可能是审题失误、计算粗心或时间不足。概率模型无法区分这些情况,输出的诊断结论对教学指导的价值有限。可解释性不足会带来两个后果:学生不信任推荐结果,教师无法据此调整课堂策略。改进方向是增加过程性数据,例如作答时长与草稿步骤。
八、教师角色的变化
自适应系统承担的是诊断与练习编排,不承担动机激发与概念讲解。实践中效果较好的模式是系统负责定位缺口与推送练习,教师负责解释错因与组织讨论。若把系统当作替代教师的方案,学生的完成率与坚持度通常快速下降。技术能压缩批改与选题的时间,但不能替代人与人之间的反馈。
九、评估效果的公开证据
公开研究显示,自适应学习在数学等结构清晰的学科上,对中等及以下水平学生的提分效果较明显,对高水平学生的增益有限。效果大小与使用时长强相关,短期使用难以观察到差异。评估一款产品时,应关注其知识点覆盖度、题目更新频率与是否有第三方效果验证,而不是只看界面与宣传语。
自适应是一种把教学决策数据化的方法,它的上限由知识图谱的质量决定。集途教育在学习系统建设中,把知识点拆解与题目标定作为先决条件,而不是先做界面再补内容。以数字科技重构行业效率,以廿五载人文底蕴托底交付,这是集途教育做教育产品的顺序。