学校本地化部署大模型:成本、合规与运维
一、为什么学校开始考虑本地部署
过去两年,学校使用生成式人工智能的主要方式是调用云端接口。随着课堂场景增多,两个问题浮现:学生作文、成绩、家庭信息等数据出校,与个人信息保护要求存在张力;课堂高峰时段接口延迟,影响使用体验。本地部署的思路是把模型放在校内服务器或私有云上,数据不出校园。它解决的是数据流向与响应稳定性,代价是前期的硬件与人力投入。
二、硬件成本的实际量级
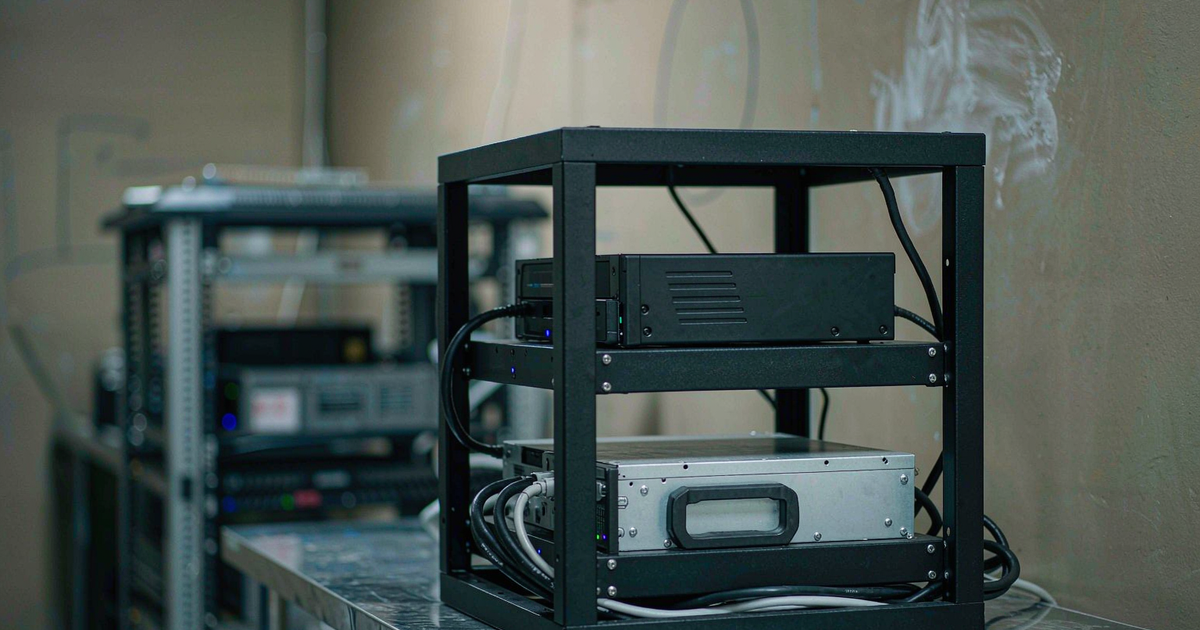
能支撑一个班级并发的推理服务,通常需要一块具备较大显存的加速卡,显存二十四吉字节以上较为常见。整机成本在两万到八万元区间,取决于卡型与是否为新机。若服务全校,两台起步并做冗余,加上存储与网络,预算通常在十万元上下。这与按调用量付费的云接口相比,是一次性支出与经常性支出的差别。年调用量低于一定规模时,云接口更便宜。
三、模型选型与量化
校内场景多数是问答、批改建议、材料润色与知识点讲解,不需要最大参数量的模型。七亿到一百四十亿参数区间的开源模型经过量化后,可在单卡上运行,质量足以覆盖多数教学辅助任务。量化会带来精度损失,表现在长文本生成与复杂推理上更明显。可行的做法是按任务分级:简单任务用轻量模型,复杂任务路由到更大模型或云端。
四、合规的四条底线
第一条是数据最小化,只采集完成教学任务必需的信息,不额外留存。第二条是告知与同意,涉及未成年人的数据处理需取得监护人同意,并说明用途与期限。第三条是访问控制,教师与学生的权限分离,操作留痕。第四条是内容安全,输出需过滤,且要有教师复核环节。四点写入制度,比写在采购需求里更有约束力。
五、网络与安全的现实约束
校内网络通常有出口审计与访问控制,本地服务需要在不影响教学网络的前提下发布。常见方案是部署在内网,只允许校内地址访问,教师端通过统一认证登录。若需校外访问,要经过反向代理与身份校验,并限制并发。日志留存需符合网络安全等级保护的要求,访问日志与操作日志分开存储。
六、运维的三个隐性成本
第一是模型更新。开源模型迭代快,半年到一年就有明显更强的版本,重新部署需要重新测试与调参。第二是提示词与知识库维护。校本资料的整理、切片、更新是持续工作,往往比部署本身更耗人力。第三是故障响应。推理服务对显存与温度敏感,假期闲置后重启可能出现兼容问题,需要有值班安排。
七、效果评估的方式
评估不应只看回答是否流畅,而要看三个指标:任务完成率、教师修改比例、学生使用时长。任务完成率指教师直接采纳的比例,修改比例反映输出的可用程度,使用时长反映真实需求。三项指标连续四周稳定,才说明部署有效。缺少评估的部署,容易变成开学展示一次、之后闲置的设备。
八、替代方案
若预算与人力有限,可以考虑混合方案:敏感数据相关的任务在校内轻量模型上完成,非敏感的高难度任务调用云端接口,并在界面明确提示数据流向。另一种方案是采购区域教育云提供的模型服务,数据存放在区域内,运维由服务方承担。选择的关键是明确哪类数据不能出校,而不是追求全部本地化。
九、推进的顺序
先选定一个具体场景,例如教师备课材料生成或作业批改建议,用两到三周验证效果。再评估数据敏感度与合规要求,确定部署边界。然后做小规模试点,覆盖一到两个班级或一个教研组。最后根据指标决定是否扩大。把技术部署放在场景验证之后,是成本最低的顺序。
集途教育在教育科技产品的设计中会先把数据字段与用途列明,再谈模型能力,因为合规是前提而非附加项。以数字科技重构行业效率,以廿五载人文底蕴托底交付,这是集途教育处理校园人工智能落地的方式。